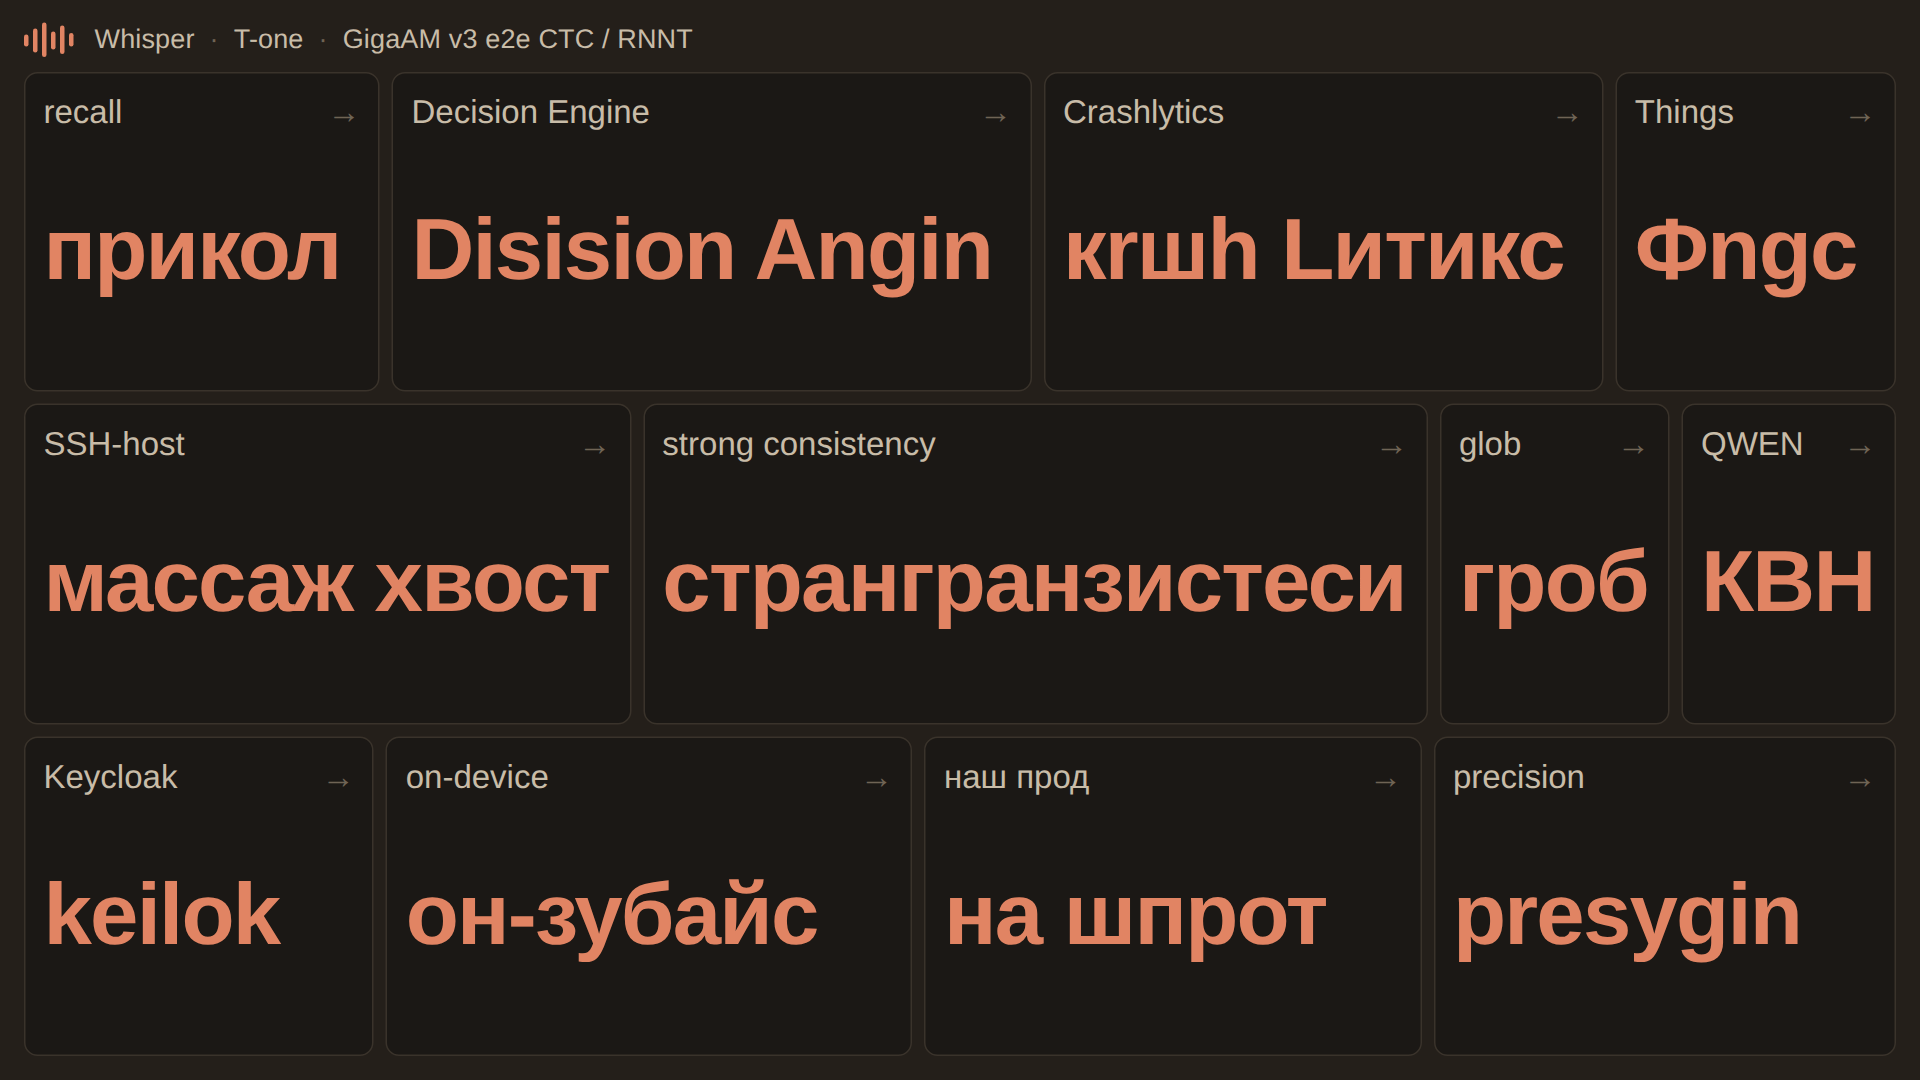
ASR для AI-разработки: как я замерял качество распознавания технических терминов
В этой статье я расскажу о том, как бенчмарк распознавания речи при AI-разработке голосом. Поговорим про сам замер, фабрики софта, постановку задач, особенности речи и датасет, посмотри на циферки и разберемся почему классический WER — очень коварная метрика, особенно в разработке.
Ну что, лонг-тапнем на диплинк и деплоим на шпрот?
Отрывок из ленты источникаЧитать у источника: Habr