Технологии17 ноября 2026 г.
Когда ИИ решает, что вам нельзя. От Codex до этикосферы Станислава Лема
Как попытка удалить несколько файлов заставила меня вспомнить классику научной фантастики и философии.
Как попытка удалить несколько файлов заставила меня вспомнить классику научной фантастики и философии.
Открытый терминальный агент от команды QwenLM: читает репозиторий, правит файлы, запускает команды в шелле. Это не чат в браузере, а CLI в духе Claude Code / Gemini CLI (проект как раз форк Gemini CLI). Из России поставить сам CLI обычно не проблема. Ломается другое: официальный вход и официальная оплата. Бесплатный Qwen OAuth закрыт, а подписку Plus/Pro и кабинет Alibaba Cloud с российской карты «Мир» или через СБП, как правило, не пополнить.
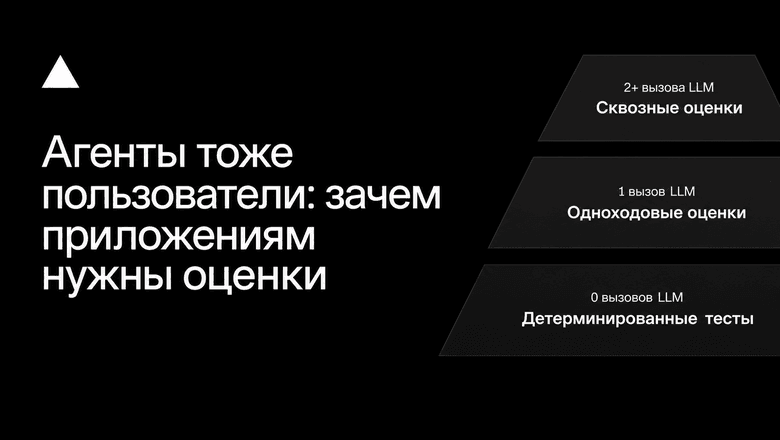
Агенты пользуются API и инструментами от имени людей. Авторы Vercel объясняют, как построить сквозную оценку с Harbor, выбрать метрики и проанализировать результаты на примере заказа кофе.
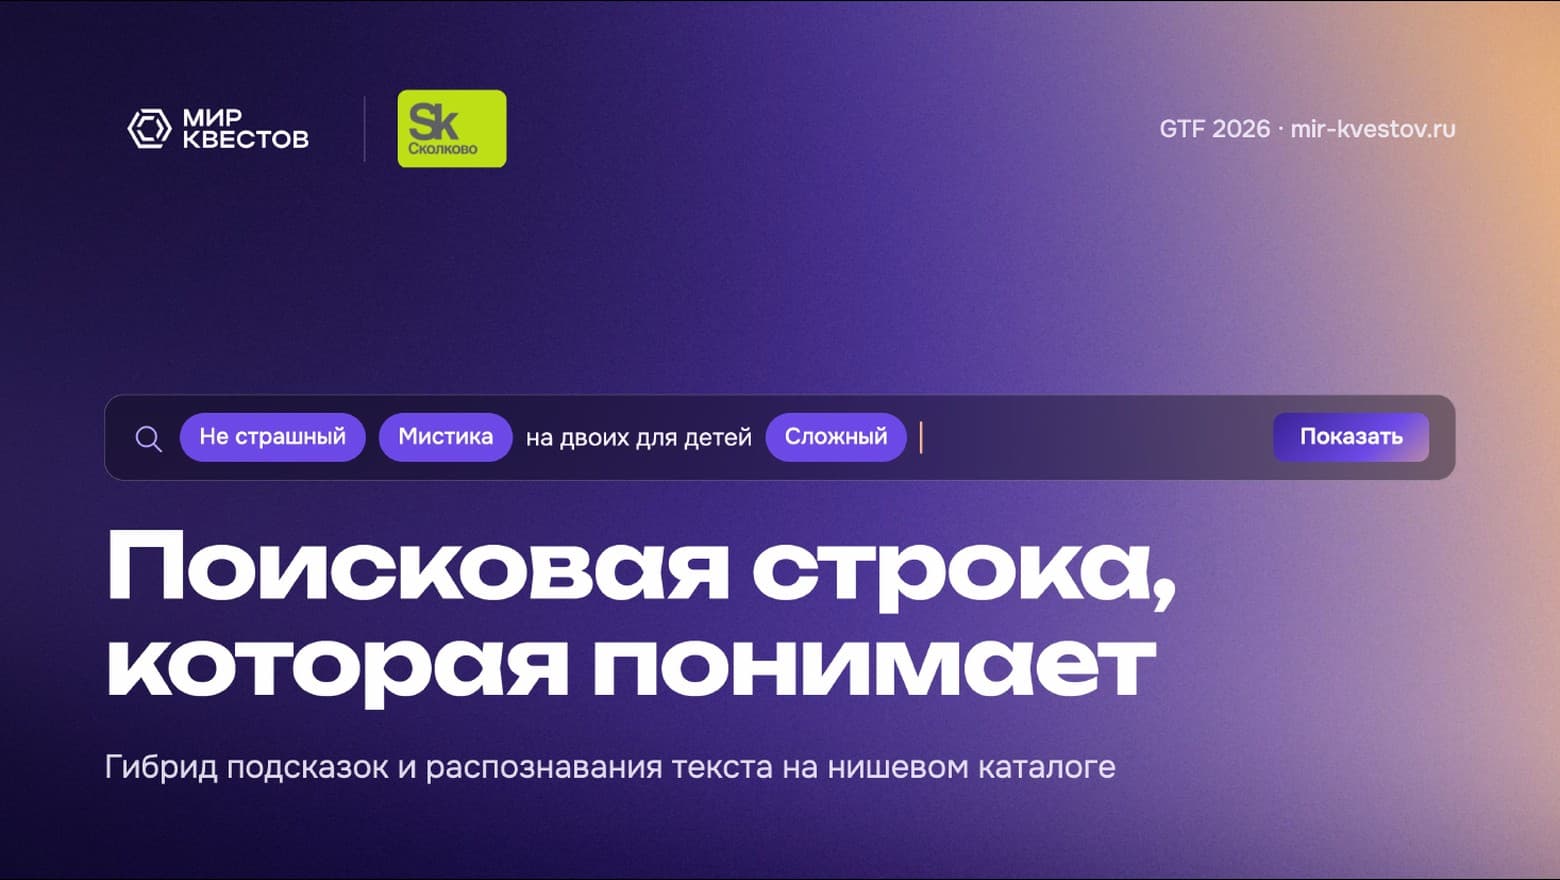
У нишевого агрегатора мало данных: 65% посетителей не авторизованы, истории просмотров нет, а в каталоге всего три тысячи квестов. Рассказываю, как мы в Мире Квестов заменили историю опросом покупателей, решающим деревом сжали анкету из 120 галочек до трёх кликов по подсказкам и добавили шесть LLM-классификаторов, которые разбирают запрос вроде «страшный на двоих», пока посетитель печатает. Внутри метрики поиска и сравнение с подходами больших компаний.
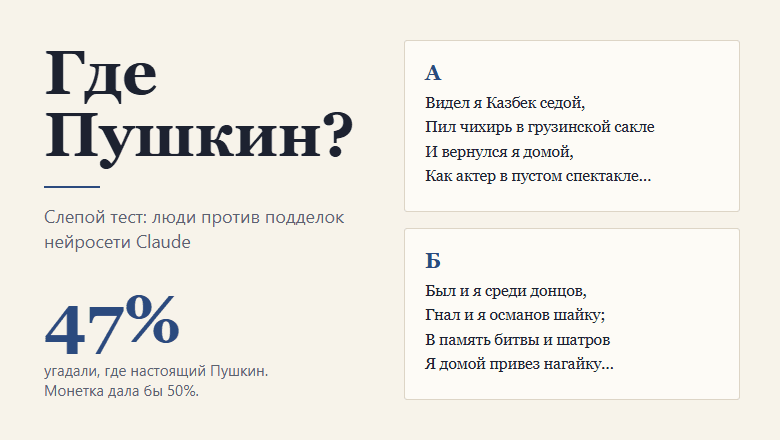
А смогли бы вы отличить стихотворение, написанное А. С. Пушкиным, от подделки нейросети Claude Opus 5.5? А повторить то же самое 10 раз? Я вот не смог. В 2024 году в журнале Scientific Reports вышла статья, описывающая эксперимент, в котором люди вслепую угадывали, написан ли отрывок Шекспиром, Байроном, Уитменом и другими известными англоязычными поэтами или нейросетью GPT-3.5.
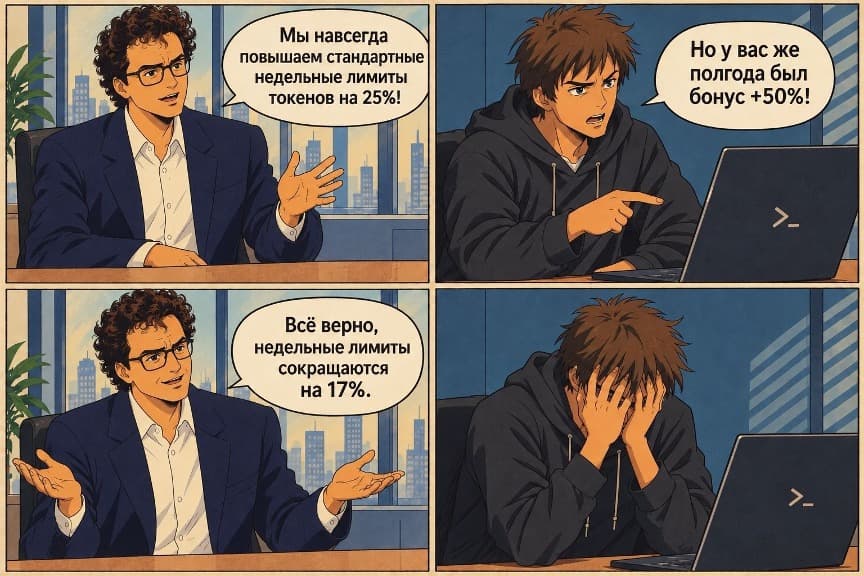
OpenAI и Anthropic грешат одним — постоянно меняют лимиты, которые входят в подписки. Причём официально эти объёмы они не публикуют, а значит, могут крутить их как хотят. Устав от этой неразберихи, я решил, что хочу уменьшить расход токенов. При этом вряд ли я был первым с такой гениальной идеей. Для этого уже были инструменты. Я нашёл три основных — rtk, Headroom и ripwire.
«В души умеющих испанскому языку... тьфу ты, в души научившихся письму оно вселит забывчивость, так как они перестанут упражнять память: веря написанному, они станут вспоминать всё извне, по посторонним знакам, а не изнутри, сами собою. Стало быть, ты нашёл средство не для памяти, а для припоминания. Ты даёшь ученикам мнимую, а не истинную мудрость. <...> Её порождения стоят как живые, но, если их спросить, они величаво молчат» © «Федр» Платона О чём пойдёт речь?
В первой части статьи я из любопытства проверил, какие бизнес-задачи могут решать легкие модели на недорогом VPS без видеокарты. В комментариях мне отсыпали критики, и часть ее, как водится, по делу. Так что продолжение отчасти написано в жанре работы над ошибками, и, чтобы понимать, что и почему я переделывал, лучше сначала обратиться к истокам. Сказать по правде, я и сам хотел кое-что довести до ума: повторить тесты на сервере с 8 ГБ RAM, проверить российские модели покрупнее и т.д.
Отвечает сотрудникам на вопросы по внутренним документам компании и показывает, откуда взят ответ. Строится она по схеме RAG — поиск нужных фрагментов плюс языковая модель. Это руководство для архитектора: из чего состоит стенд и где его разместить, сколько ресурсов нужно каждой модели, как выбрать хранилище и посчитать среду, что проверить до запуска и где обычно совершаются ошибки.
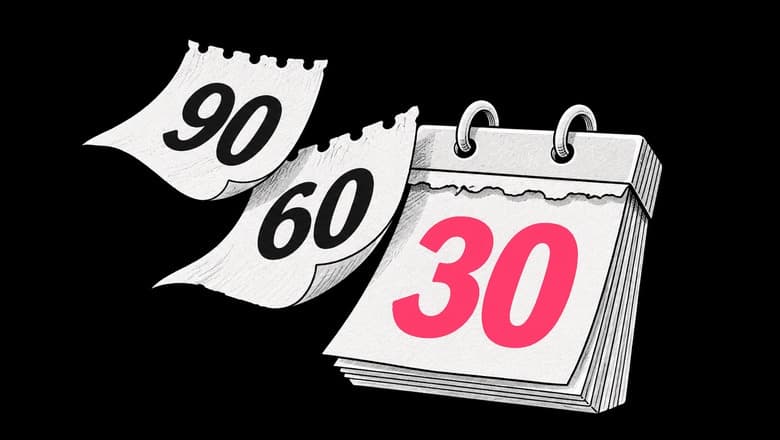
13 ноября 2026 года команда Google Project Zero объявила о переходе на фиксированные сроки раскрытия уязвимостей. Начиная с этого ноября подробности будут публиковать через 90 дней после сообщения вендору, со 2 февраля 2027 года — через 60, а с 3 января 2028 года — через 30. Готовность исправления на дату раскрытия больше не влияет. С 2021 года в проекте действовала модель «90 + 30». Если вендор исправлял ошибку в пределах 90 дней, то исследователи ждали ещё 30 дней после выпуска патча.
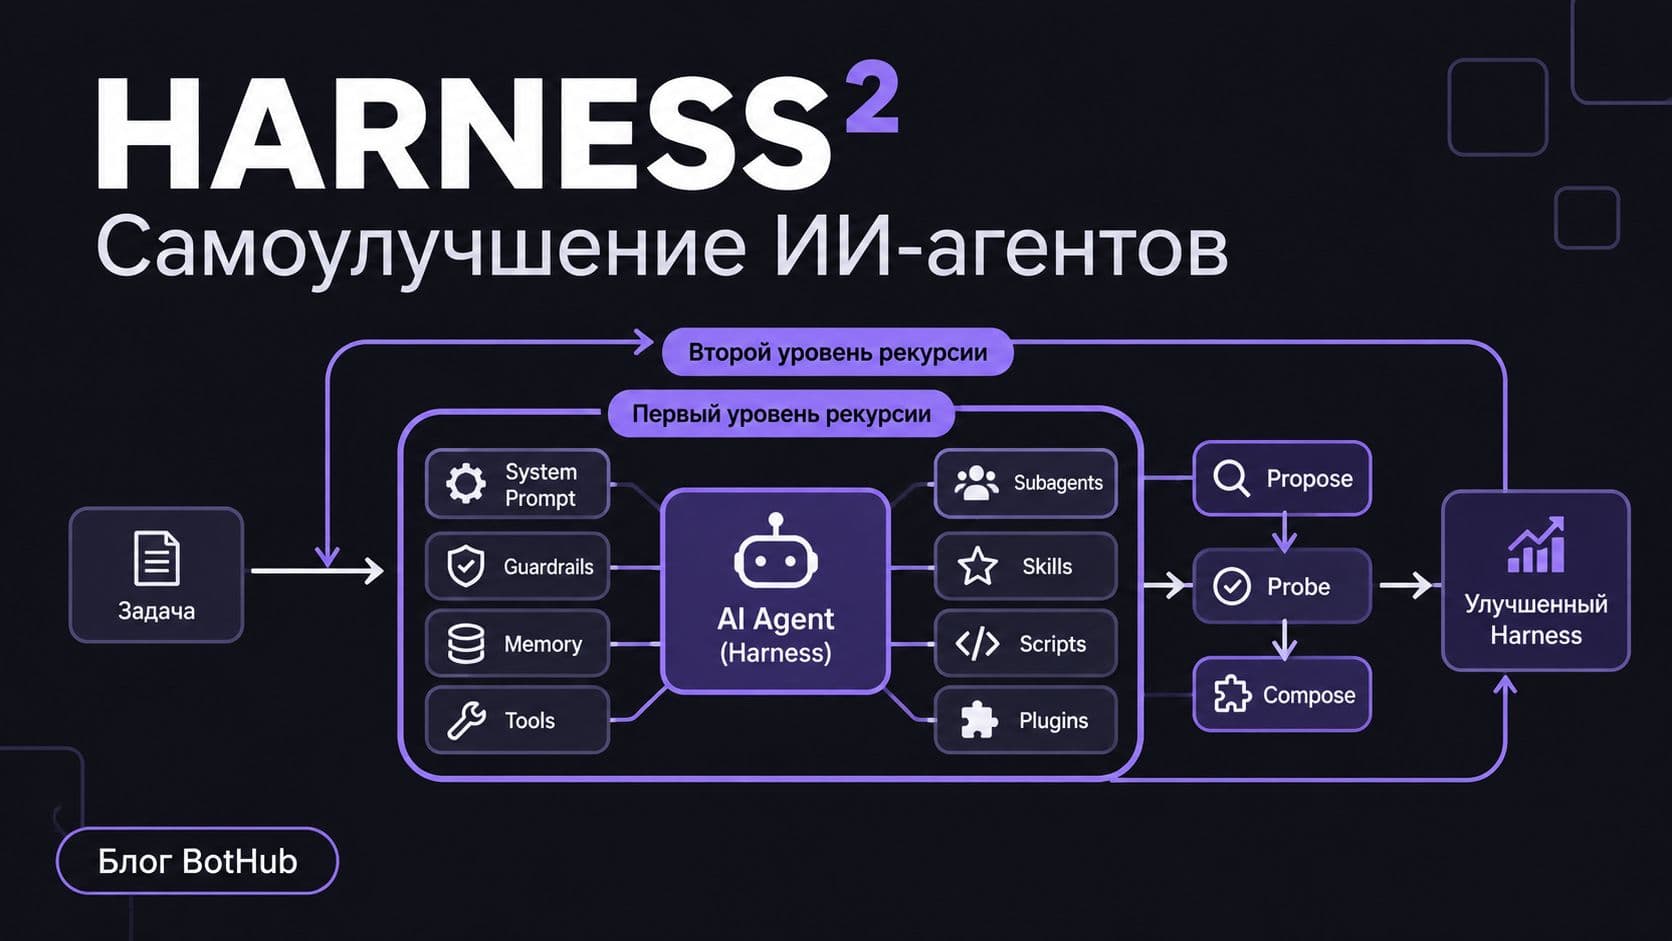
ИИ-агенты сейчас стремительно развиваются. Совсем недавно ИИ-агент был обычным чатом с LLM, где он творил что хотел. Но в последнее время вы могли даже сами слышать такие вещи, как скиллы, MCP, оркестрационный цикл, инструменты, управление контекстом, — все это составляющие части агентской системы под названием Harness. Сам агент — это LLM + Harness.
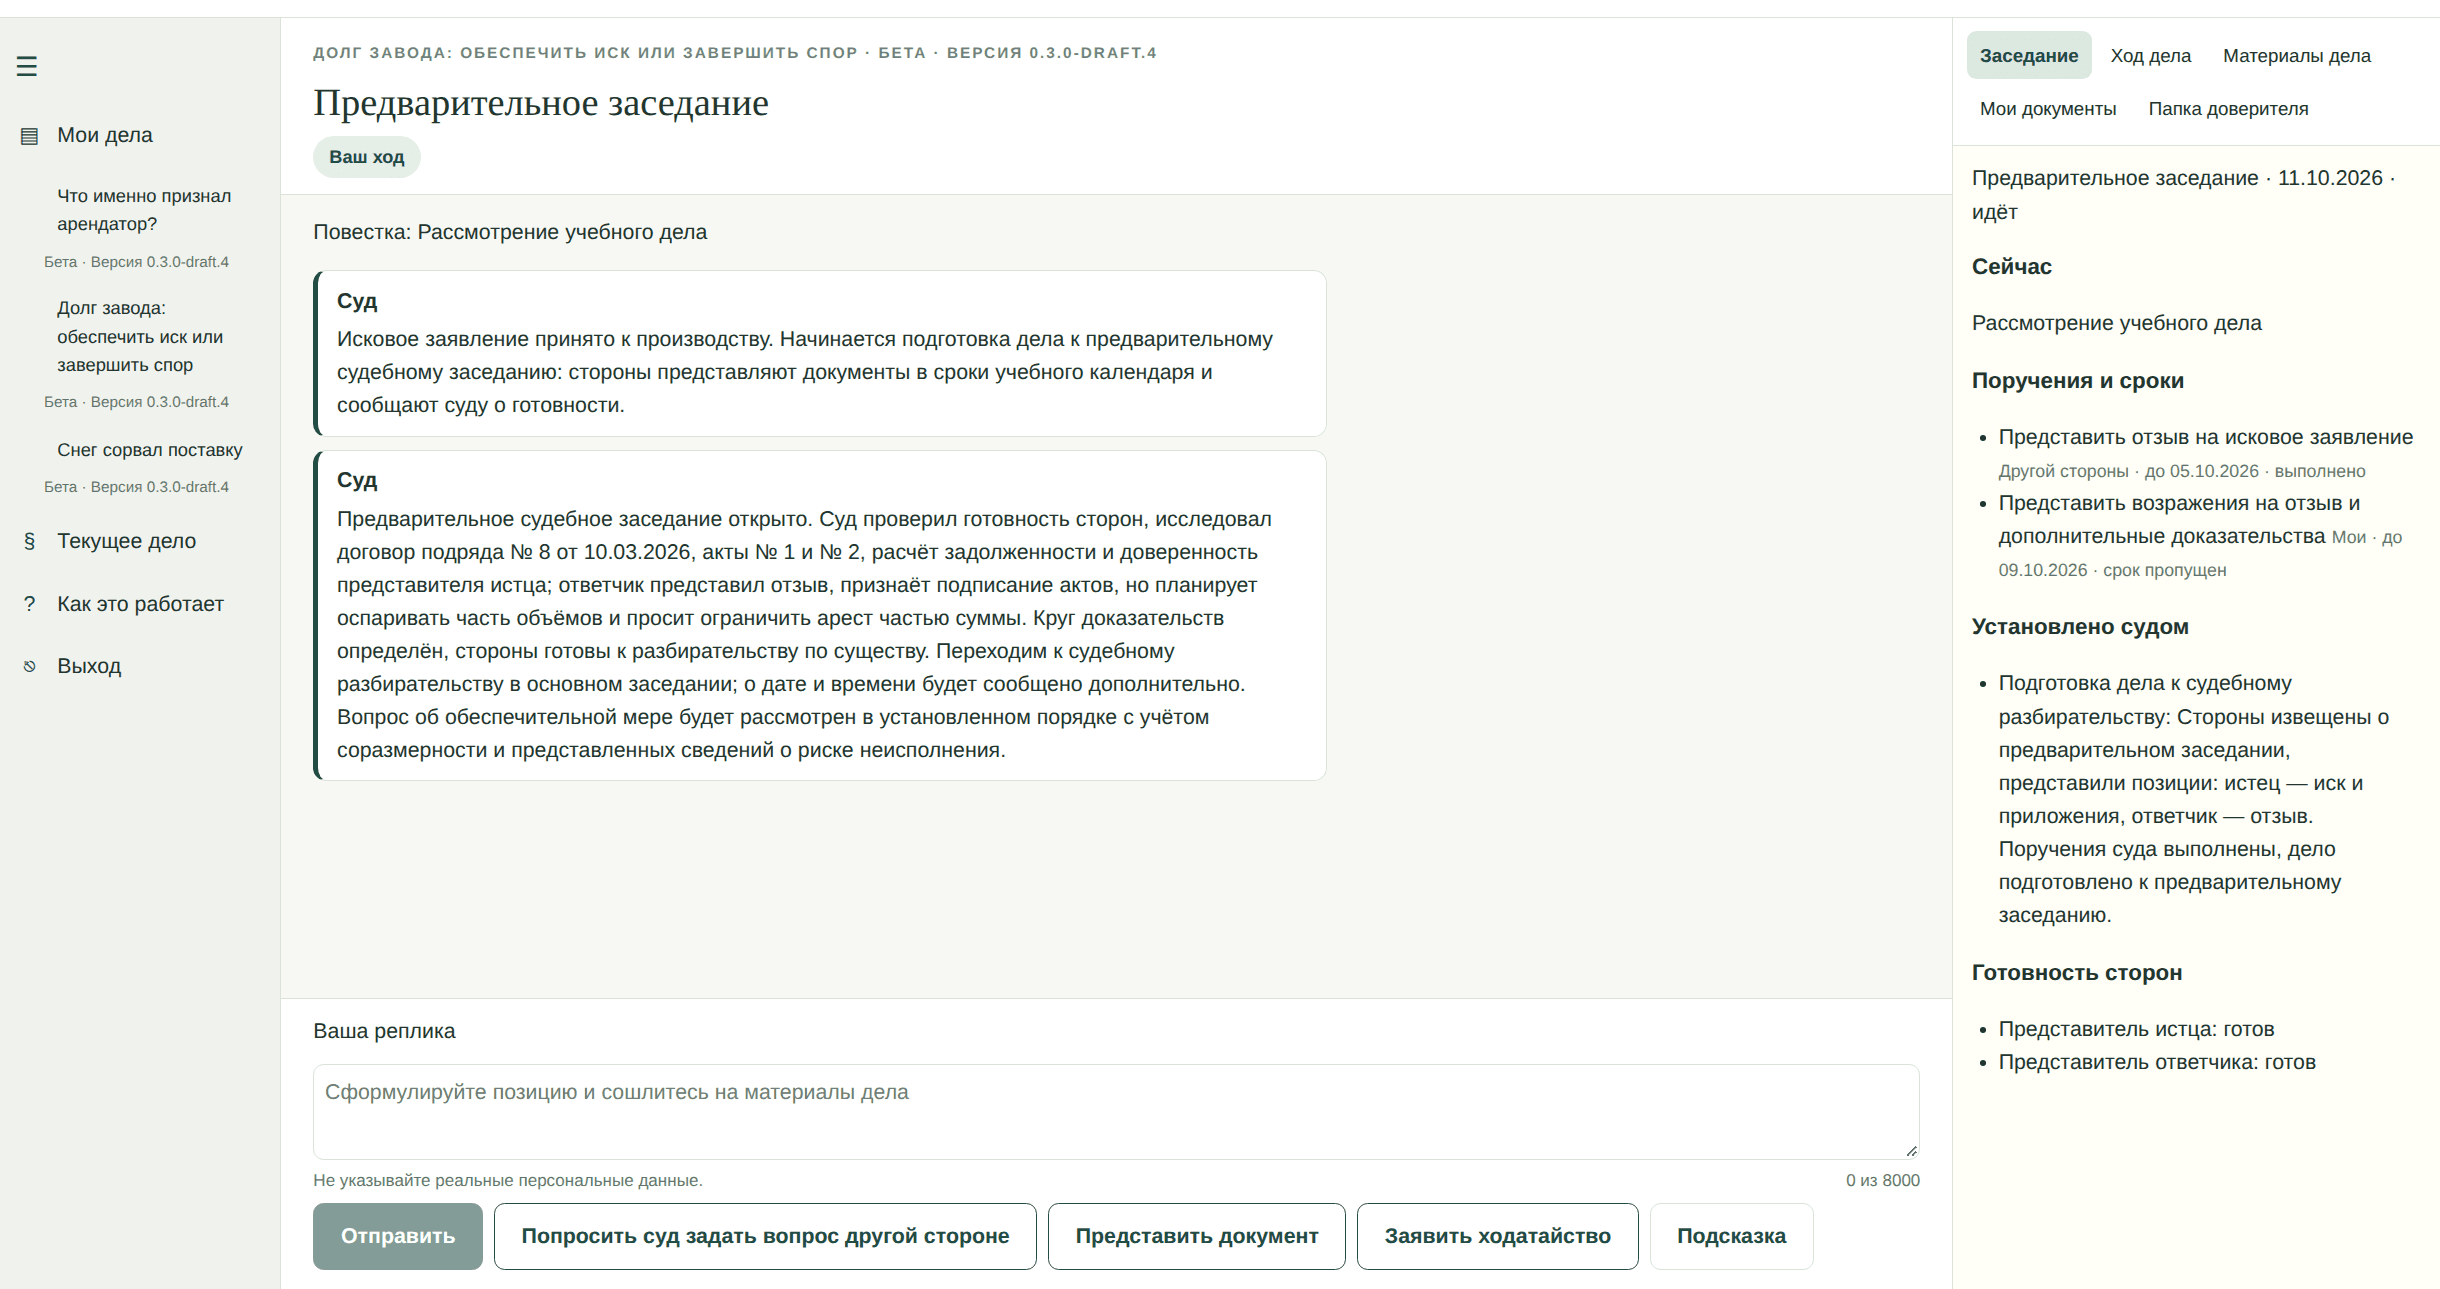
Привет, Хабр! Представь обычное домашнее задание в вузе. Преподаватель просит нейросеть составить задание, студент отдаёт её своей нейросети и сдаёт готовый ответ, а проверяет работу снова нейросеть. От подготовки задания до проверки получается переписка ИИ студента с ИИ преподавателя — ирония в том, что это может быть одна и та же модель. А люди в такой переписке только передают тексты друг другу и выступают в роли живых прокси.
Атрибуция фактов в персональной памяти LLM: гибридный поиск на Postgres + pgvector, эвалы и вопрос «чей это факт» Я загрузила в RAG свои переписки за несколько лет, чтобы мой ИИ‑агент знал меня и моих друзей. Он действительно узнал меня. А еще Клайда и Крейга из Южного Парка, Афелия из Лиги Легенд и человека, в которого я впервые влюбилась в интернете (это был ролевик за Кайто). А заодно он решил, что я айтишник, не жмот и зожник (конечно, все в мужском роде).
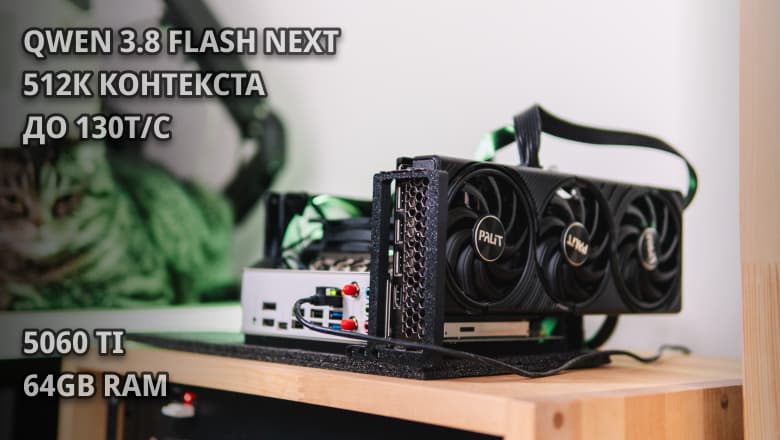
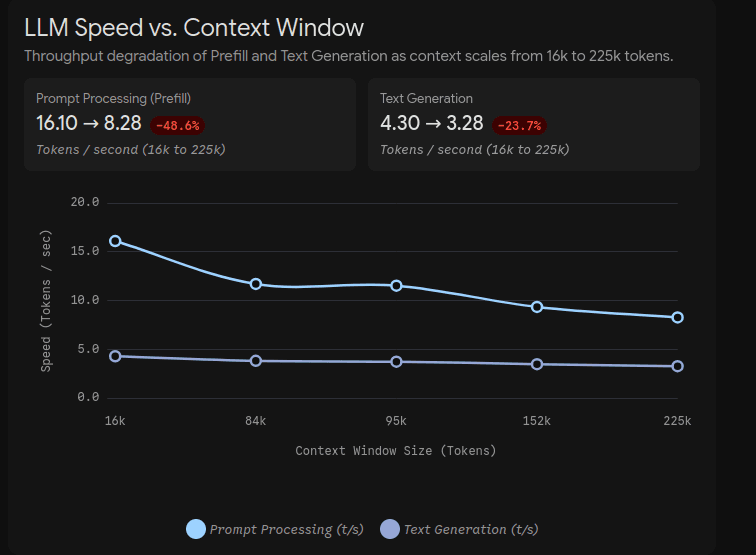
Берём видеокарту RTX 5060 Ti 16 ГБ, 64 ГБ быстрой DDR5 памяти, запускаем небольшую Qwen3.8 27B Q3 во всю vram, с околонулевым контекстом, получаем неплохую скорость, пишем сапёр/змейку — и оно работает. А дальше подключаем OpenCode, грузим реальный проект и получаем постоянное compacting, уход непонятно в какие дебри, так как она потеряла контекст. Бросаем и забываем эти ваши локальные LLM как страшный сон. Знакомо? Так выглядит типичный путь тех, кто решил поднять текстовую нейросеть дома.
Stable-diffusion.cpp: один бинарник на C++ вместо гигабайтов Python, модели в GGUF под 8 и 16 ГБ видеопамяти. Заодно сравнил девять локальных моделей на одних и тех же промптах — скорость, быстрый режим. Внутри таблица замеров и примеры картинок от каждой модели.
Я использую Opencode как рабочую среду: снимаю позиции, собираю дайджесты, проверяю страницы, отвечаю на комментарии. На прошлой неделе инструмент трижды обновился, и обновления затрагивают не косметику, а то, как строятся сценарии. Ниже разбор трёх релизов, список моделей и цифры из моих логов: сколько стоит одна длинная сессия и почему дешёвая модель делает больше вызовов, чем дорогая.
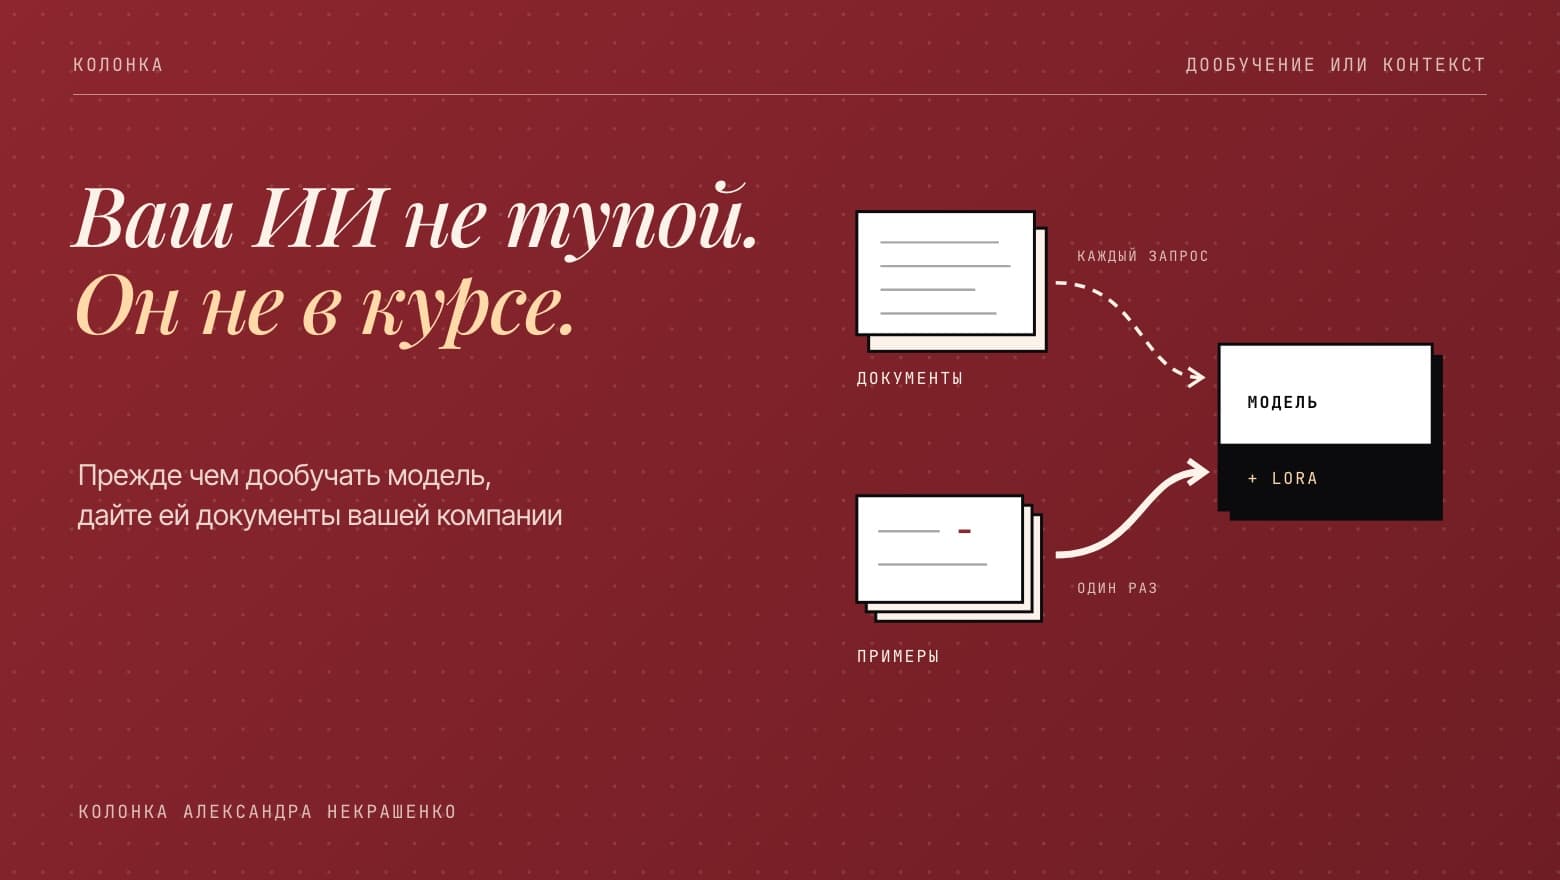
«Давайте дообучим модель на наших данных» — эту фразу я слышу почти в каждом разговоре о внедрении LLM. Обычно к этому моменту лечение уже выбрано, а диагноза ещё нет. Допустим, агент ошибся в условиях возврата товара. Ему вообще передали актуальный регламент? Поиск нашёл нужный пункт? В базе одна версия правил или три, и все помечены как действующие? Пока это не выяснено, говорить об обучении рано: у плохого ответа часто вполне административная причина. Моя позиция такая.
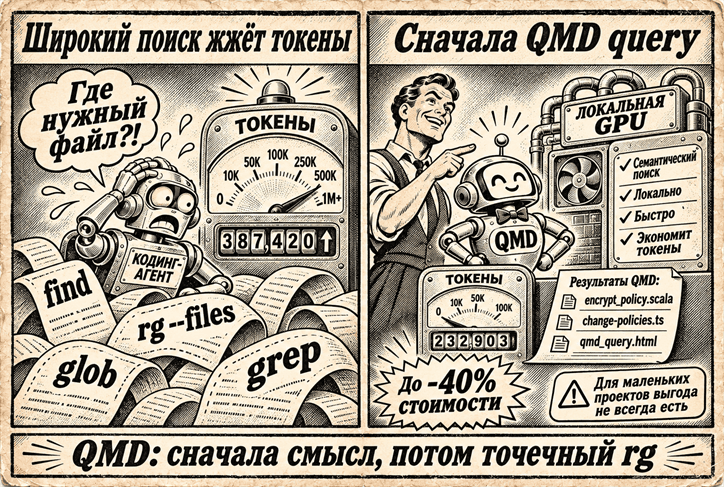
Я заметил что кодинг агенты перед выполнением задачи запускают "find, rg --files, glob" для поиска файлов и нужных классов и модулей. Потом поиск по содержимому файлов через "rg, grep". И на это сжигается много токенов. И я решил проверить можно ли сэкономить на токенах используя семантический поиск вместо всего выше перечисленного. Если локальный GPU простаивает, почему бы тогда на нем семантический поиск не гонять.
Нейронные модели сильно повлияли на программную разработку, информационную безопасность и смежные отрасли. Влияние идёт по нескольким векторам, но одно из самых опасных явлений — массовая декомпиляция закрытого проприетарного ПО. Это явление невозможно игнорировать, ведь из-за обратной разработки проприетарных программ многие могут пострадать. Хотя есть и положительная сторона.
Существует много различных проектов и вариантов по ускорению генерации AI. Но в большинстве случаев они используют тюнинг модели, а так же использование внешней видео карты. Но можно ли ускорить генерацию модели, если у нас есть только процессор и ОЗУ? Для тестирования использовалась модель Qwen3.8-Flash-Next Gyro GGUF В данной оптимизации помог Opus, который несколько суток гонял тесты на моём железе и пытался оптимизировать код llama.