Как агент улучшил себя, не тронув ни одного веса: разбираем The Trinity
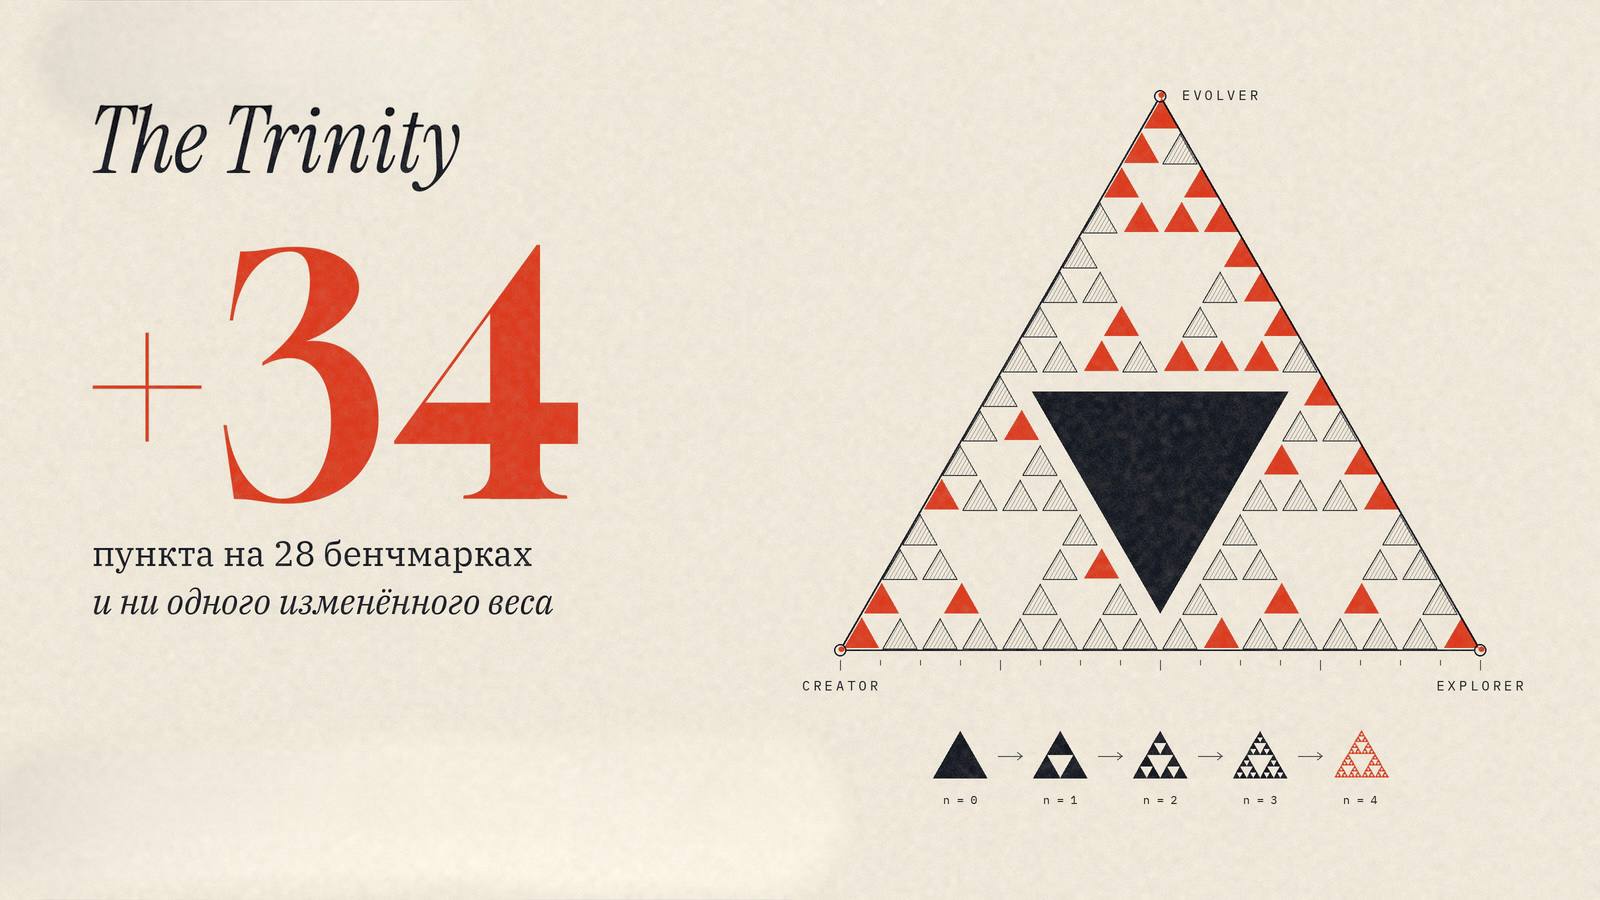
26 октября на arXiv вышла работа The Trinity: Capability-Driven Recursive Self-Improvement for Multimodal Agents. Авторов 21, на странице Hugging Face указан Национальный университет Сингапура.
Через два дня статья стала второй работой дня на Hugging Face Papers и собрала почти 400 голосов. Заявка в аннотации громкая: агент четыре итерации подряд улучшает сам себя и прибавляет в среднем 34 пункта на 28 обучающих бенчмарках и 26 — на 18 новых, которых при обучении не видел. Среди новых — два настоящих робота.
При этом веса модели не меняются вообще: внутри замороженная Claude Opus 5, ни одного шага градиента за всю работу. Улучшается обвязка (harness) — код вокруг модели, который решает, что ей показать, что запомнить и когда остановиться. А учится эта обвязка не на самих бенчмарках, а на упрощённых мирах, которые система строит себе сама. Слова «рекурсивное самоулучшение» звучат как заявка на прорыв, но заголовочные +34 и +26 складываются из нескольких частей, и не все они показывают то, что обещает аннотация. Настоящая находка в работе тоже есть, только не там, где её ждёшь.
В этой статье мы разберём, как устроена The Trinity: дерево способностей, три роли, самодельные симуляции и роутер. Потом посмотрим на цифры и отдельно на то, из чего сложены 26 пунктов на новых задачах.
Это отрывок. Полностью — на сайте Habr